Supervision et métriques
Sur cette page
Chaque serveur TOSIAM expose ses métriques au format Prometheus sur <contexte>/metrics, par exemple https://am.example.com/tosiam/metrics. Un serveur Prometheus les collecte ; la page Métriques de la console et, si vous en avez un, Grafana les interrogent ensuite dans Prometheus. Pour savoir si un serveur répond, isAlive.jsp suffit.
-
Prometheus vers Serveurs TOSIAM
Collecte de
/tosiam/metrics, avec authentification Basic - Serveurs TOSIAM vers Prometheus Métriques au format Prometheus
- Console et Grafana vers Prometheus Requêtes PromQL par l’API de Prometheus
- Prometheus vers Console et Grafana Séries pour la page Métriques et les tableaux Grafana
Activer le point /metrics#
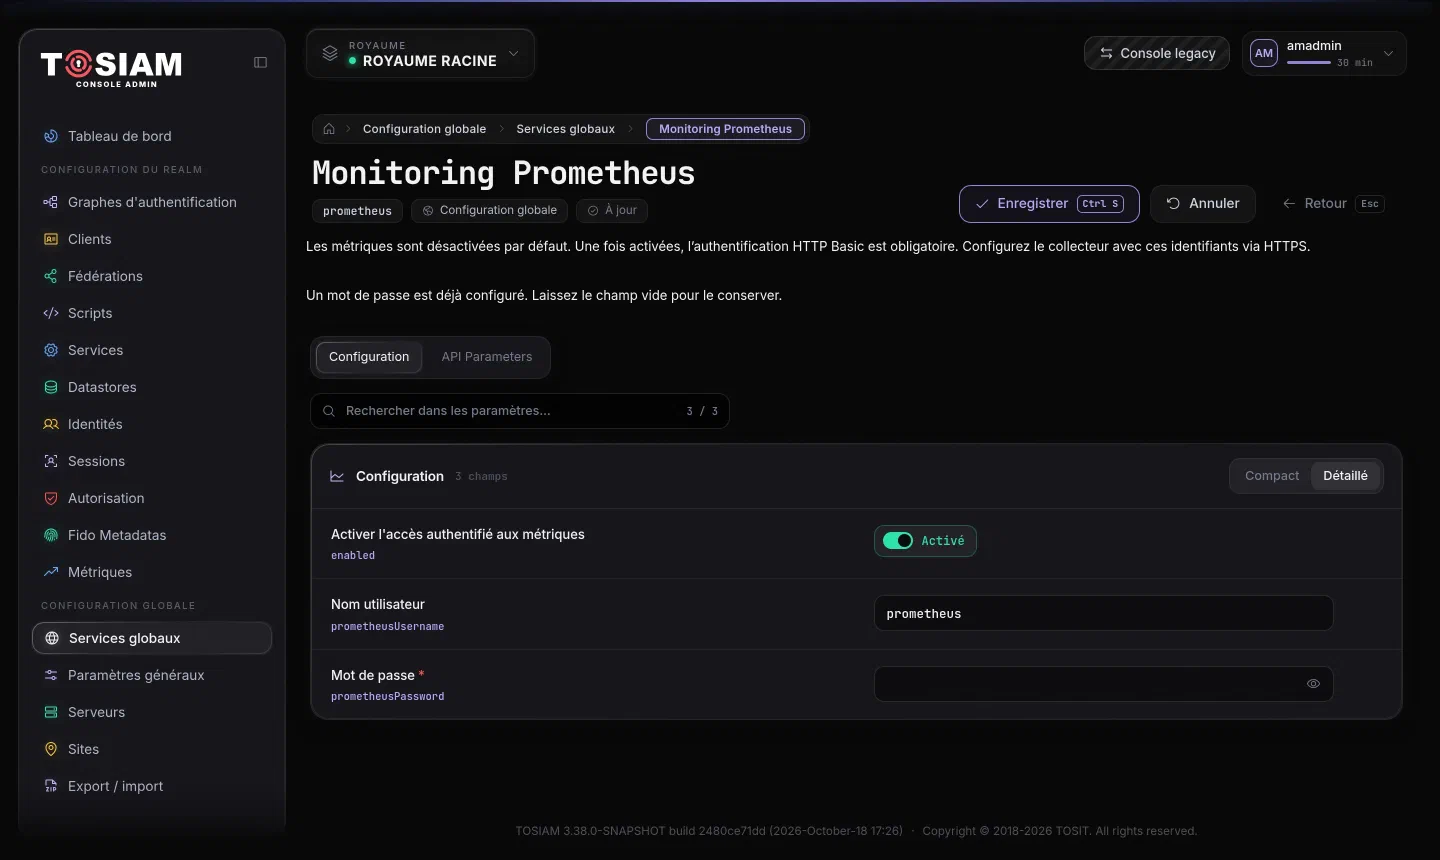
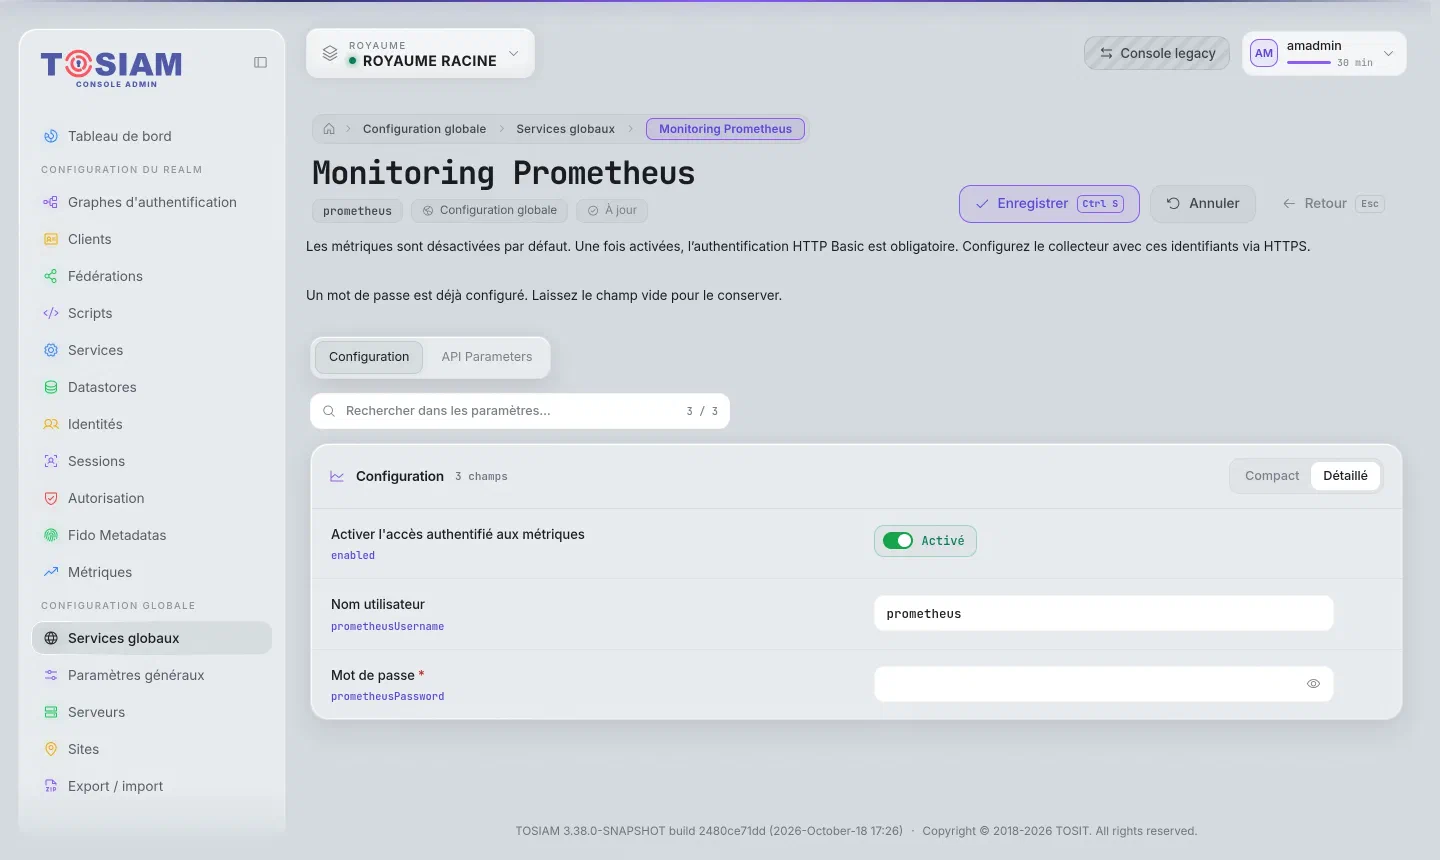
Le point de terminaison est désactivé à l’installation, et protégé par une authentification HTTP Basic dès qu’il est activé : sans les bons identifiants, il répond 401. Il se règle dans le service global Monitoring Prometheus (console : Services globaux, groupe observabilité ; iPlanetAMPrometheusService en ligne de commande).
 1
2
| Réglage | Attribut | Rôle |
|---|---|---|
| Activer l’accès authentifié aux métriques | iplanet-am-prometheus-enabled | false par défaut : /metrics répond toujours 401. |
| Nom utilisateur | iplanet-am-prometheus-username | Identifiant que Prometheus présente. |
| Mot de passe | iplanet-am-prometheus-userpassword | Mot de passe associé, stocké chiffré. |
| URL Prometheus | iplanet-am-prometheus-url | Adresse du serveur Prometheus, utilisée par la page Métriques de la console (voir plus bas). Onglet API Parameters dans la console. |
Les trois premiers réglages sont lus à chaque collecte : une modification s’applique sans redémarrage. Ce ne sont pas des comptes TOSIAM : choisissez un identifiant dédié à la collecte.
Avec ssoadm :
cat > prometheus.properties <<'EOF'
iplanet-am-prometheus-enabled=true
iplanet-am-prometheus-username=prometheus
iplanet-am-prometheus-userpassword=<mot de passe>
EOF
chmod 600 prometheus.properties
ssoadm set-attr-defs -s iPlanetAMPrometheusService -t Global -D prometheus.properties
rm prometheus.properties
Vérification :
curl -s -u prometheus:<mot de passe> https://am.example.com/tosiam/metrics | headLa réponse est au format texte Prometheus (text/plain; version=0.0.4).
Configurer Prometheus#
Déclarez chaque serveur TOSIAM comme cible, avec le chemin /<contexte>/metrics et les identifiants Basic :
scrape_configs:
  - job_name: tosiam
    metrics_path: /tosiam/metrics
    scheme: https
    basic_auth:
      username: prometheus
      password_file: /etc/prometheus/tosiam-metrics-password
    static_configs:
      - targets:
          - tosiam1.example.com:8443
          - tosiam2.example.com:8443
Interrogez chaque serveur séparément : chaque instance a ses propres compteurs, et l’agrégation se fait dans Prometheus (sum by (...)). Sans basic_auth, la cible apparaît down avec l’erreur 401 Unauthorized dans Status › Targets.
Métriques exposées#
Les métriques sont produites avec Micrometer. Les noms suivent les conventions Prometheus : un compteur se termine par _total ; une durée produit _seconds_count, _seconds_sum, _seconds_max et, pour les histogrammes, _seconds_bucket.
| Domaine | Métriques | Labels |
|---|---|---|
| Authentification | am_authentication_attempts_total, am_authentication_success_total, am_authentication_failure_total ; durée am_authentication_latency_seconds | realm, service, module (et outcome pour la durée) |
| Sessions | am_session_active (jauge), am_session_creations_total (sessions créées), am_session_destroyed_total, am_session_timeout_total | reason (destroy, logout), type (idle, max) |
| OAuth2 | am_oauth2_access_token_issued_total, am_oauth2_refresh_token_issued_total, am_oauth2_token_introspection_total, am_oauth2_token_revoked_total | realm, grant_type, token_type |
| SAML 2.0 | am_saml_assertions_issued_total, am_saml_response_validation_success_total, am_saml_idp_sso_success_total, am_saml_idp_sso_failure_total | realm, idp, fault_code |
| Annuaire LDAP | am_ldap_connections_active (jauge), am_ldap_connections_acquired_total, am_ldap_operations_total ; durée am_ldap_operation_latency_seconds | operation (search, bind) |
| Caches | am_cache_entries (jauge), am_cache_hits_total, am_cache_misses_total, am_cache_removals_total | cache (sessionCache, policyCache…) |
| Scripts | am_script_execution_total, am_script_execution_errors_total ; durée am_script_execution_time_seconds | script, language, error_type |
| Requêtes HTTP | http_server_requests_seconds (histogramme) | method, status, uri, realm |
| JVM et système | jvm_memory_*, jvm_gc_*, jvm_threads_*, jvm_classes_*, process_cpu_usage, system_cpu_usage, system_load_average_1m | area, id… |
Un compteur n’apparaît qu’après son premier événement : un serveur qui n’a encore refusé aucune connexion n’expose pas am_authentication_failure_total.
Le label uri des requêtes HTTP est normalisé pour limiter le nombre de séries, et pour qu’aucun nom choisi par un appelant (royaume, utilisateur, graphe, client) ne devienne une valeur de label :
- les consoles (
/console,/console-legacy,/XUI) sont regroupées sous leur préfixe ; - l’API REST
/apiest ramenée à la forme du chemin :/api/realms/{realm}/users/{id},/api/realms/{realm}/authgraphs/{id}. Tout segment que l’API ne définit pas est remplacé par{id}; - ailleurs, les identifiants (UUID, nombres, jetons) sont remplacés par
{id}; - une requête vers un chemin inconnu qui reçoit
404est comptée sousuri="NOT_FOUND", avec unrealmvide : un robot qui essaie des adresses ne crée pas une série par adresse.
Le label realm vaut / pour le royaume racine, y compris pour les appels /api/realms/root/... de la console.
S’y ajoutent des mesures plus anciennes, sans préfixe am_, sur lesquelles s’appuie la page Métriques de la console : AuthenticationServiceV1_authenticate, TokenEndpointResource_token, CTS_create (et CTS_read, CTS_update, CTS_delete), DJLDAPv3Repo_authenticate, CTS_queue_size, et les tailles de cache InternalSessionCache_cache, IdCachedServicesImpl_idRepoCache, CachedSMSEntry_smsEntries.
Compter une étape d’un parcours#
Le nœud MeterNode ajoute vos propres compteurs : placé dans un graphe d’authentification, il incrémente à chaque passage un compteur dont vous choisissez le nom (am_graph_meter_total par défaut) et les labels. Le label realm est ajouté par défaut.
Exemples de requêtes#
# Taux d'échec d'authentification par royaume, sur 5 minutes
sum by (realm) (rate(am_authentication_failure_total[5m]))
  / sum by (realm) (rate(am_authentication_attempts_total[5m]))

# Sessions actives, toutes instances confondues
sum(am_session_active)

# Jetons d'accès émis par minute, par type d'autorisation
sum by (grant_type) (rate(am_oauth2_access_token_issued_total[5m])) * 60

# 95e centile du temps de réponse de l'authentification REST
histogram_quantile(0.95, sum by (le) (rate(http_server_requests_seconds_bucket{uri="/json/authenticate"}[5m])))
La page Métriques de la console#
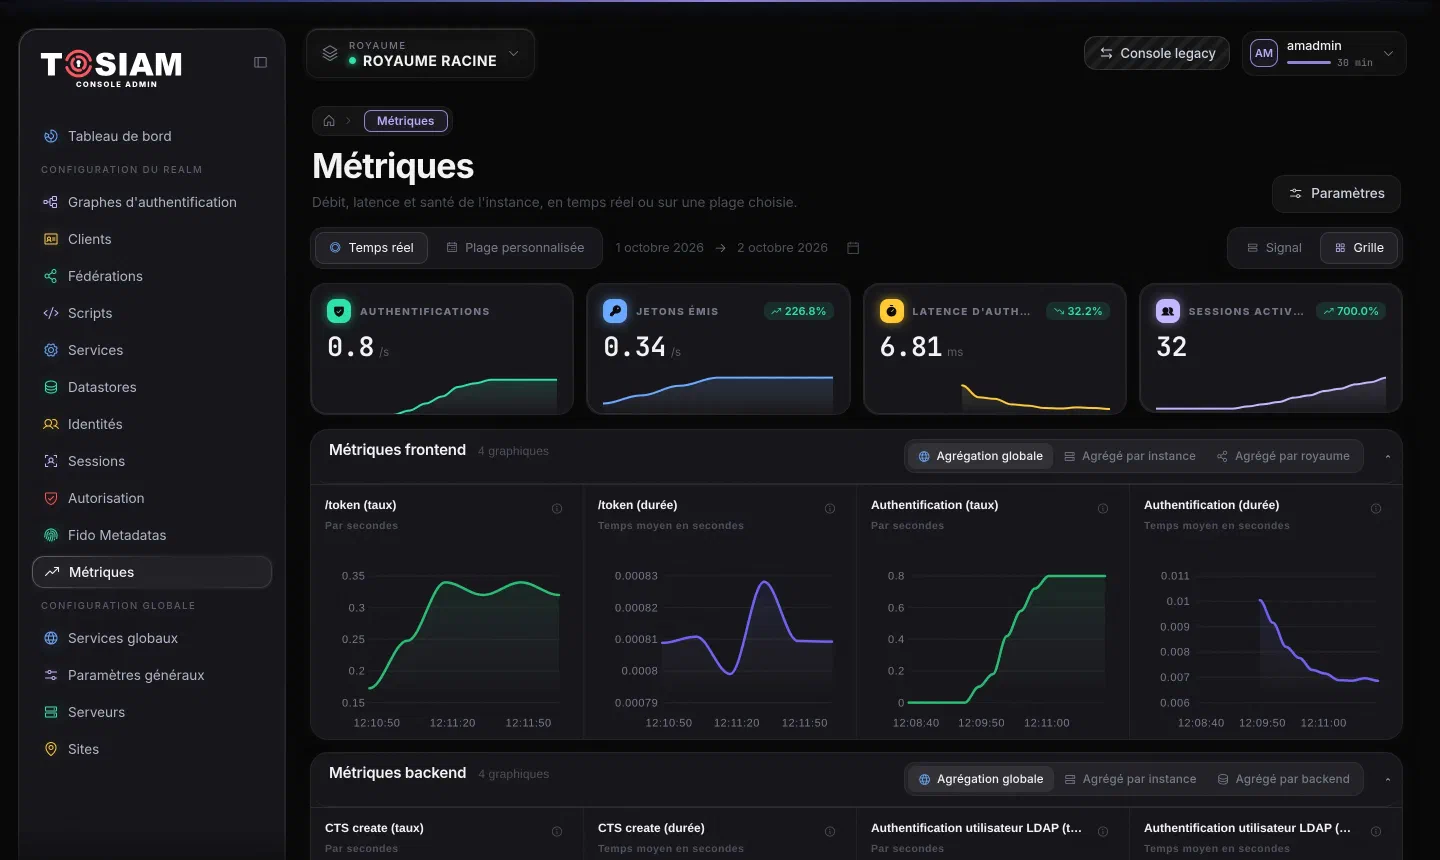
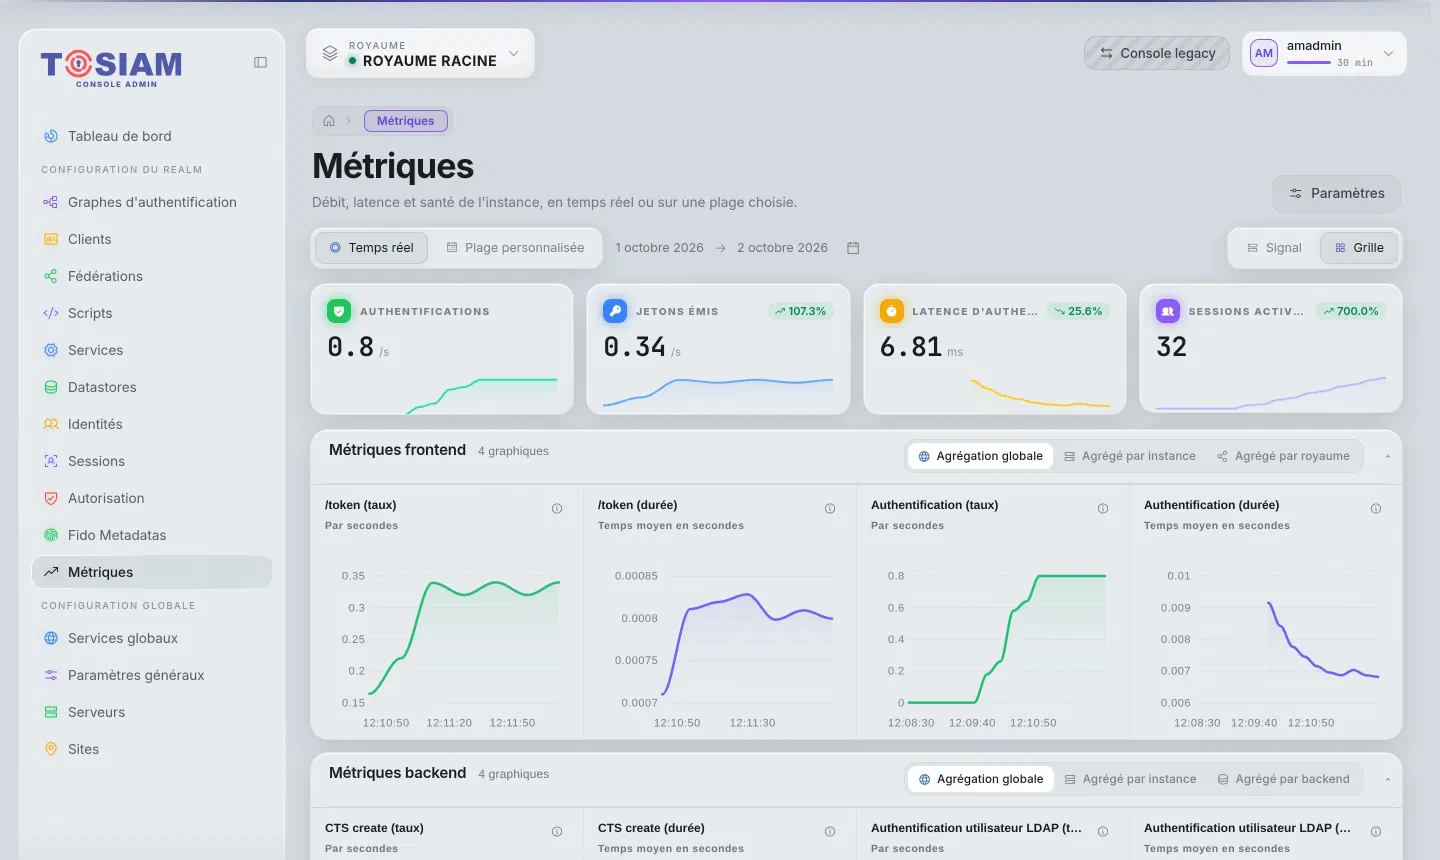
La page Métriques de la console affiche des graphes tirés de Prometheus. Elle n’interroge pas /metrics : le navigateur de l’administrateur appelle directement l’API de Prometheus (/api/v1/query_range) à l’adresse du réglage URL Prometheus, modifiable aussi par le bouton Paramètres de la page. Cette adresse doit donc être joignable depuis le poste de l’administrateur. Tant qu’elle n’est pas renseignée, la page propose de la configurer.
 1
2
3
4
La page montre quatre indicateurs (authentifications, jetons émis, latence d’authentification, sessions actives) et quatre groupes de graphes :
| Groupe | Contenu |
|---|---|
| Métriques frontend | Taux et durée des appels à /token et à l’authentification, agrégés globalement, par instance ou par royaume |
| Métriques backend | Taux et durée des écritures CTS et des authentifications LDAP, par instance ou par annuaire |
| Métriques techniques | Mémoire, processeur, disque et réseau des machines : nécessite node_exporter, collecté sous le job node |
| Métriques internes | Entrées en cache (configuration, utilisateurs, sessions) et file d’attente du CTS |
La période se choisit entre Temps réel (dernières 24 heures, actualisé toutes les 15 secondes) et Plage personnalisée.
Superviser les annuaires TosDJ#
Depuis la version 3.38.0, chaque serveur TosDJ (configuration, CTS, utilisateurs) peut exposer ses propres métriques au format Prometheus, sur le chemin /metrics/prometheus de son connecteur HTTP (httpPort, 8080 dans l’installation pas à pas). Sans ce point, les données de supervision d’un annuaire ne se lisent que par LDAP (cn=monitor) ou par l’API REST /admin/monitor.
Activer le point /metrics/prometheus#
Le point est désactivé à l’installation. Il s’active à chaud avec dsconfig, sur chaque serveur :
dsconfig set-http-endpoint-prop --endpoint-name /metrics/prometheus --set enabled:true \
  -h <hôte> -p 4444 -D "cn=Directory Manager" -w <mot de passe> -X -n
--set enabled:false le désactive de la même façon : il répond alors 503.
Prometheus s’authentifie en HTTP Basic avec un compte de l’annuaire, qui doit détenir le privilège monitor-read ; aucun mot de passe n’est écrit dans la configuration de TosDJ. Le compte de service uid=tosiam,ou=system,<suffixe> reçoit ce privilège à l’installation. Pour un autre compte :
ldapmodify -h <hôte> -p 1389 -D "cn=Directory Manager" -w <mot de passe> <<'LDIF'
dn: uid=prometheus,ou=system,dc=example,dc=com
changetype: modify
add: ds-privilege-name
ds-privilege-name: monitor-read
LDIF| Requête | Réponse |
|---|---|
| Sans identifiants, mot de passe faux ou compte inconnu | 401 |
Compte authentifié sans le privilège monitor-read | 403 |
| Compte authentifié avec le privilège | 200, format texte Prometheus |
| Point désactivé | 503 |
Le privilège est nécessaire parce que cn=monitor est lisible par tout compte dans la configuration livrée : sans lui, n’importe quel utilisateur de l’annuaire obtiendrait les métriques.
Vérification :
curl -s -u "uid=tosiam,ou=system,dc=example,dc=com:<mot de passe>" https://tosdj1.example.com:8080/metrics/prometheus | headAnnuaire installé avant la version 3.38.0#
La mise à jour d’un annuaire existant ne crée ni l’entrée de configuration du point de collecte, ni le privilège du compte de collecte. Deux opérations, une fois par serveur :
# 1. créer le point de collecte, activé
dsconfig create-http-endpoint --endpoint-name /metrics/prometheus --type prometheus-endpoint \
  --set enabled:true --set authorization-mechanism:"HTTP Basic" \
  -h <hôte> -p 4444 -D "cn=Directory Manager" -w <mot de passe> -X -n

# 2. donner le privilège monitor-read au compte de collecte (commande ldapmodify ci-dessus)
Sans la seconde, Prometheus reçoit 403.
Configurer Prometheus#
Un job par ensemble d’annuaires, avec le compte de collecte :
scrape_configs:
  - job_name: tosdj
    metrics_path: /metrics/prometheus
    scheme: https
    basic_auth:
      username: uid=tosiam,ou=system,dc=example,dc=com
      password_file: /etc/prometheus/tosdj-metrics-password
    static_configs:
      - targets:
          - config1.example.com:8080
          - cts1.example.com:8080
          - users1.example.com:8080
Utilisez scheme: http si le connecteur HTTP de l’annuaire n’est pas en TLS.
Métriques exposées#
| Famille | Contenu |
|---|---|
tosdj_* | Toutes les valeurs numériques de cn=monitor : connexions, opérations par connecteur, backends, réplication, file de travail |
jvm_*, process_*, system_* | Métriques JVM de Micrometer : mémoire, ramasse-miettes, threads, processeur |
Le nom d’une métrique tosdj_* est celui de l’attribut de cn=monitor, en minuscules et avec des _ : ds-mon-add-operations-total-count devient tosdj_ds_mon_add_operations_total_count. L’étiquette monitor donne l’entrée de supervision d’origine ; elle vaut monitor pour les compteurs de l’entrée cn=monitor elle-même (tosdj_current_connections, tosdj_max_connections, tosdj_total_connections). Le texte d’aide (# HELP) rappelle l’attribut d’origine.
Ces noms sont stables : les tableaux de bord et les alertes peuvent s’y fier. Ils ne suivent pas les conventions de nommage de Prometheus :
- toutes les métriques
tosdj_*sont déclaréesgauge, compteurs cumulés compris, car un attribut de supervision ne dit pas s’il est cumulé.rate()s’applique normalement aux compteurs ; promtool check metricslit l’exposition sans erreur de format, mais signale les suffixes_countde ces compteurs ;- pour les entrées de réplication, le port de la connexion du pair est retiré de l’étiquette (
DS(12) 172.18.0.7:45678devientDS(12) 172.18.0.7), afin qu’une reconnexion ne crée pas de nouvelle série.
Exemples :
# ajouts par seconde dans le CTS, par connecteur
rate(tosdj_ds_mon_add_operations_total_count{job="tosdj"}[1m])

# connexions ouvertes sur chaque annuaire
tosdj_current_connections{monitor="monitor"}
Vérifier l’état d’un serveur#
/tosiam/isAlive.jsp lit la configuration du serveur dans le config store (TosDJ) :
| Réponse | Signification |
|---|---|
200 (« Server is ALIVE ») | Serveur configuré, config store joignable |
500 (« Server is DOWN ») | Config store injoignable |
302 | Serveur pas encore configuré, ou mise à jour en attente |
Une sonde doit exiger exactement 200 : beaucoup d’outils acceptent les redirections 3xx par défaut.
Pour un équilibreur de charge, retirez un serveur de la ferme quand isAlive.jsp ne répond plus 200. Sous Kubernetes, l’image TOSIAM distingue trois sondes : readiness sur isAlive.jsp, et liveness sur la seule ouverture du port HTTP, pour qu’une panne de TosDJ ne fasse pas redémarrer tous les serveurs.
Voir aussi Scalabilité & haute disponibilité.
Mis à jour le